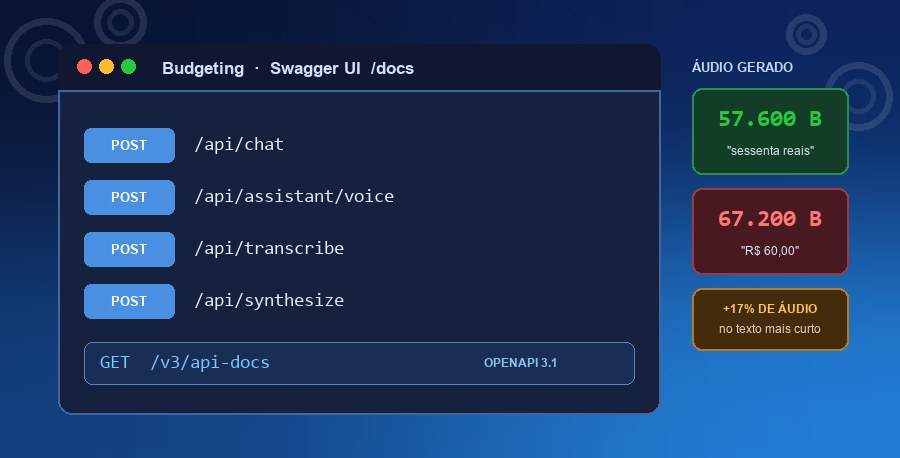
No artigo sobre o Postman, a API e o cliente eram duas coisas separadas: de um lado o Spring Boot rodando, do outro uma coleção que eu montei na mão. Com o Swagger é diferente — o cliente nasce do próprio código. As anotações que você escreve nos controllers viram uma interface capaz de disparar requisições, aceitar upload de arquivo e tocar áudio no navegador. Neste artigo eu percorro o Budgeting, um assistente financeiro por voz feito com Spring AI, para mostrar que a documentação não é uma página que se lê: é um cliente HTTP completo.
http://localhost:8080/docs ·
Contrato cru: http://localhost:8080/v3/api-docs
⚙️ Antes de começar
- Suba a aplicação com
./mvnw spring-boot:rune abrahttp://localhost:8080/docs. - Tenha uma chave da OpenAI configurada — os endpoints de voz fazem chamadas reais aos
modelos
whisper-1,gpt-4o-miniegpt-4o-mini-tts. - Os áudios de teste já estão no repositório, em
src/test/resources/audio/. - Faça os exercícios na ordem, sem reiniciar a aplicação no meio. O banco é um H2 em memória: reiniciar zera os dados e quebra a dependência entre um exercício e o seguinte.
🧭 Anatomia da página
Todo endpoint no Swagger UI segue o mesmo ritual: expandir a barra, clicar em Try it out, editar o exemplo, apertar Execute e rolar para ler a resposta. O que vale entender é que nada ali foi escrito à mão — cada elemento da tela vem de uma anotação no código:
| O que você vê na tela | De onde vem |
|---|---|
| Texto cinza descrevendo o endpoint | @Operation |
| Corpo marcado como obrigatório | @RequestBody |
| Aba Schema com campos e tipos | @Schema |
| Tabela Responses com os status possíveis | @ApiResponse |
| Botão Escolher arquivo no lugar de um campo de texto | @Parameter + MediaType.MULTIPART_FORM_DATA_VALUE |
💬 Registrar e consultar em linguagem natural
Expanda POST /api/chat, clique em Try it out e
troque o exemplo por um gasto seu:
POST http://localhost:8080/api/chat

{
    "message": "Gastei 25 reais na Loft Hamburgueria"
}
A resposta confirma o registro:
{
    "reply": "Gasto de vinte e cinco reais na Loft Hamburgueria registrado com sucesso."
}
Nesse único Execute aconteceu bastante coisa: o modelo interpretou a frase, escolheu a tool
registrarGasto, extraiu o valor e a descrição, e o Java executou um INSERT no banco.
Agora pergunte o total, sem sair do mesmo endpoint:
{
    "message": "Quanto eu gastei este mes?"
}
{
"reply": "Voce gastou trinta e cinco reais este mes."
}
Repare que o total (35) não bate com o gasto que você acabou de registrar
(25) — e é exatamente isso que se quer ver. A tool
consultarTotalDoPeriodo fez um SELECT sobre o mês inteiro,
somando o que já existia. Não é o modelo ecoando a última frase: tem banco de verdade atrás.
Dá para conferir em http://localhost:8080/h2-console.
⚠️ Quando dá errado: RFC 7807
Agora provoque um erro de propósito — deixe a mensagem vazia e execute:
{
    "message": ""
}
O retorno vem como 400 em
application/problem+json:
{
    "detail": "Um ou mais campos da requisicao sao invalidos.",
    "instance": "/api/chat",
    "status": 400,
    "title": "Dados invalidos",
    "errors": {
        "message": "A mensagem nao pode ser vazia"
    }
}
Três coisas para observar. O content-type não é um JSON qualquer: segue a
RFC 7807, o padrão de resposta de erro em HTTP. O campo errors diz
qual campo falhou e por quê, em vez de um "erro interno" genérico. E, o mais
interessante, esse 400 já estava anunciado na tabela Responses antes de você
provocá-lo — a documentação previu o erro porque ele faz parte do contrato.
🎙️ O pipeline de voz em uma requisição
Aqui o Swagger faz algo que uma coleção de testes não faz com a mesma naturalidade. Expanda
POST /api/assistant/voice: o campo file aparece
como um botão Escolher arquivo, porque o controller declarou o parâmetro como
multipart/form-data. Selecione src/test/resources/audio/almoco.ogg e execute.
Leva cerca de 8 segundos — são quatro chamadas à OpenAI em sequência: transcrição, interpretação, execução da tool e síntese de voz.
O Response body vira um player de áudio (o navegador reconheceu o
audio/mpeg) e você ouve a resposta. Mas o mais revelador está nos
Response headers, que expõem o pipeline por dentro:
x-transcription: O+Matheus+gastou+R%24+60%2C00+hoje+de+almo%C3%A7o.%0A
x-reply: O+gasto+de+sessenta+reais+referente+ao+almo%C3%A7o+foi+registrado+com+sucesso.
Compare os dois: a transcrição capturou R$ 60,00 literalmente, enquanto a resposta diz
"sessenta reais". Isso não é acaso — é uma regra do SYSTEM_PROMPT,
e daqui a pouco a gente mede o motivo dela existir. O texto aparece codificado porque header HTTP não
aceita caracteres fora do ASCII, então passa por URLEncoder.
🔍 Isolando a transcrição
Quando um assistente de voz responde algo estranho, existem dois suspeitos: ou o
Whisper ouviu errado, ou o modelo interpretou errado. O endpoint
POST /api/transcribe resolve essa dúvida sozinho — mande o mesmo
almoco.ogg:
{
    "text": "O Matheus gastou R$ 60,00 hoje de almoço.\n"
}
Em cerca de 2 segundos você sabe se a culpa é da escuta, sem gastar as chamadas de chat e de síntese. É a vantagem de expor cada etapa do pipeline como um endpoint próprio, em vez de só o fluxo completo.
Note o \n no fim: é o Whisper devolvendo assim
mesmo. E cuidado para não confundir o Response body (o que aconteceu de verdade) com o
Example Value (só uma ilustração do schema).
📊 Ouvindo uma decisão de design
Este é o exercício que muda a natureza da ferramenta: o Swagger deixa de ser cliente de teste e vira
instrumento de medição. Use POST
/api/synthesize duas vezes, com o mesmo conteúdo escrito de formas diferentes, e compare o
content-length da resposta.
{ "text": "Voce gastou sessenta reais este mes." }   // 36 caracteres

{ "text": "Voce gastou R$ 60,00 este mes." } // 30 caracteres| Formato | Caracteres | Bytes de áudio | Diferença |
|---|---|---|---|
| Por extenso — "sessenta reais" | 36 | 57.600 | referência |
| Com símbolo — "R$ 60,00" | 30 | 67.200 | +9.600 bytes (~0,6 s) |
O resultado é contraintuitivo: o texto mais curto gerou 17% mais áudio. O motivo é que o sintetizador não interpreta o símbolo — ele soletra "erre cifrão sessenta vírgula zero zero", que demora bem mais para falar do que "sessenta reais".
Aquela regra do SYSTEM_PROMPT — "escreva os valores por extenso, nunca com símbolo ou
numeral" — deixou de ser preferência pessoal e virou número medido. Duas
requisições no navegador foram suficientes para transformar uma opinião em evidência.
Detalhe de implementação: /api/synthesize usa
ContentDisposition.attachment(), por isso baixa o arquivo; já
/api/assistant/voice usa inline(), e por isso toca direto na página.
🗂️ Tabela-resumo dos endpoints
| Verbo | Rota | Entrada | Retorno |
|---|---|---|---|
| POST | /api/chat | message (texto livre) | JSON com reply |
| POST | /api/assistant/voice | file (áudio) | MP3 + headers do pipeline |
| POST | /api/transcribe | file (áudio) | JSON com text |
| POST | /api/synthesize | text | MP3 para download |
🔗 O JSON por trás da interface
A interface bonita é só uma leitura de um arquivo. O contrato de verdade está em
/v3/api-docs, no formato OpenAPI 3.1:
curl http://localhost:8080/v3/api-docsE é esse JSON que destrava o resto do ecossistema:
- Importar no Postman ou Insomnia — a coleção sai pronta, sem montar rota por rota.
- Gerar clientes com o
openapi-generator, em Java, Python, TypeScript. - Gerar tipos para o front-end, mantendo back e front em sincronia.
- Validar em CI que uma mudança não quebrou o contrato publicado.
É aqui que as anotações se pagam. @Operation e @Schema não servem só para
deixar a página legível — elas viram entrada de ferramenta.
Os dois, e sem competição. O Swagger vive junto do código: sobe com a aplicação e está sempre sincronizado com o que foi realmente entregue — ideal para explorar e para quem chega agora. O Postman guarda o que a documentação não guarda: cenários salvos, variáveis de ambiente, requisições encadeadas e scripts de teste. Na prática, o Swagger é onde você descobre a API; o Postman é onde você ensaia um fluxo repetidas vezes.
🚧 Limitações
- O player mostra duração
0:00— o MP3 devolvido pela OpenAI não traz o header Xing. O áudio toca normalmente fora dali. - Uploads grandes (perto de 25 MB) travam a interface. Nesses casos,
curlresolve melhor. - Não há histórico: cada Execute substitui o resultado anterior.
- Exploração manual não substitui teste automatizado. A garantia continua sendo
./mvnw test.
✅ Conclusão
O Swagger não substitui os testes automatizados. O que ele entrega é outra coisa: poucos segundos entre uma dúvida e uma resposta observável. Quando o assistente responde algo estranho, dá para isolar a transcrição e descobrir se quem errou foi o Whisper ou o modelo. E, como no exercício do áudio, dá até para transformar uma regra de prompt em número medido.
Anotação bem escrita não é burocracia: é ferramenta.
O projeto completo, com a arquitetura hexagonal e o guia original, está em Globant — Java Spring Boot AI Developer / budgeting, e o resumo técnico está na página do projeto.